pgbee
in corso· 2026 · in evidenza
Un'estensione per PostgreSQL: dichiari in SQL che una colonna si ricava da altre con un modello, e il database la tiene compilata, versionata e con i costi registrati.
Il perché
Le garanzie stanno nel database, in SQL e PL/pgSQL: coda, versioni, lineage e correzioni umane. Il worker è sostituibile, e sotto i crash pgbee non lascia righe vuote né sovrascrive chi ha corretto a mano.
Quando una colonna la riempie un modello (la categoria di un ticket, un riassunto, un embedding) servono sempre le stesse cose: una coda, i retry, sapere quale prompt ha prodotto quale valore, non sovrascrivere chi ha corretto a mano. pgbee le mette dentro Postgres.
Come funziona
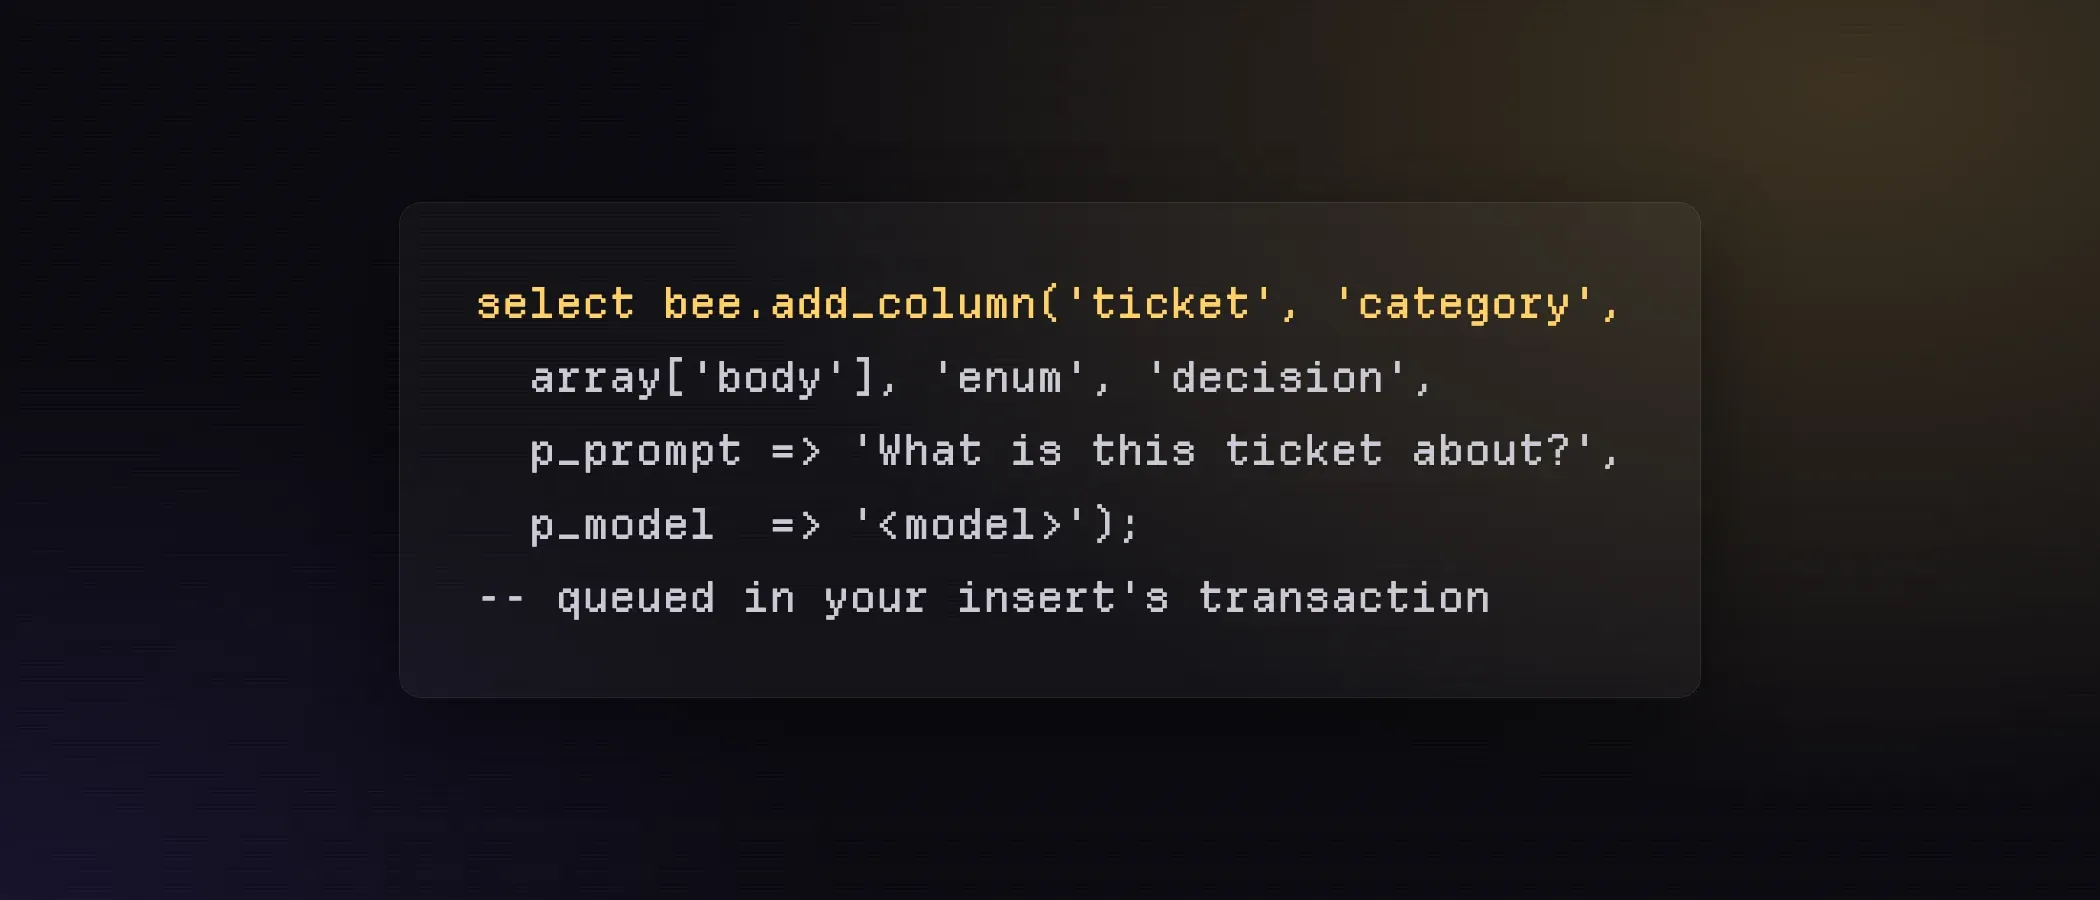
bee.add_columndichiara la colonna: tabella, colonne sorgente, tipo, prompt e modello. Da lì i trigger mettono in coda ogni riga nuova o cambiata, e parte il backfill.- Un worker prende i job con un contratto di quattro funzioni e chiama il modello (OpenRouter, OpenAI o un modello locale). Quello in Python è il riferimento, ma va bene qualsiasi processo che parla il contratto.
- Ogni valore porta con sé modello, versione del prompt, confidenza e costo. Un valore corretto a mano non viene più toccato.
- Quattro backend: modelli linguistici con output strutturato, modelli di decisione con le probabilità delle classi, embedding, e worker propri.
I numeri
Field test su 3.000 reclami veri del database pubblico CFPB, con quattro colonne derivate: 12.000 job, zero falliti, zero ritentati, circa 0,14 dollari ogni 1.000 righe. Quando il modello è sicuro (confidenza 0,9 o più) concorda con l’etichetta del consumatore l’86-88% delle volte, sotto 0,5 solo il 32-35%: la confidenza serve a mandare in revisione le righe dubbie.
Poi l’ho messo sotto crash contro due design classici fatti lato applicazione, “salva e poi accoda” e l’outbox transazionale: processi uccisi ogni 60 operazioni, coda esterna che cade, prompt cambiato a metà, persone che correggono il 3% dei valori. Su 2.000 righe pgbee non lascia righe vuote, non tiene valori vecchi che sembrano freschi e non sovrascrive nessuna correzione; gli altri due sì.
È open source con licenza Apache 2.0.