Local LLM Experiments
completato· 2026
Quanto regge il coding agentico con modelli locali su un MacBook Pro M5 da 32 GB, misurato contro i modelli cloud.
Il perché
Il perimetro di validità e quello che non ho misurato sono scritti prima dei risultati.
Volevo sapere se un modello locale può fare davvero da coding agent, non in una demo ma in un harness che scrive un’app intera. Il task è sempre lo stesso: una CRUD con backend FastAPI e SQLite e frontend React, generata da zero e valutata con una rubrica fissa.
- Su uno scaffold piccolo, Qwen3.6-35B-A3B quantizzato a 4 bit con MLX ha fatto 18 su 18 in 3,5-7 minuti, senza correzioni umane. Replicato due volte.
- Sullo stesso task Opus 4.7 ha fatto 17 su 18 a 0,76 dollari a run, DeepSeek V4 Flash 17 su 18 a 0,002: il costo cambia di quattro ordini di grandezza, il risultato resta nel rumore della rubrica.
- Per il tool calling in locale servono tre cose allineate: il training del modello, il chat template e il parser del server. Se un anello è rotto, il modello fallisce appena installato.
- Spezzare il lavoro in una roadmap salva i modelli fragili ma rompe quelli capaci, perché il reset del contesto fra un task e l’altro fa perdere coerenza.
Il perimetro è stretto e lo dico nel repo: un solo task, quasi tutte le celle con N=1, nessun dato su refactor o contesti lunghi. Vale come punto di partenza qualitativo, non come benchmark. Log, codice generato, punteggi e costi di ogni run sono pubblici.
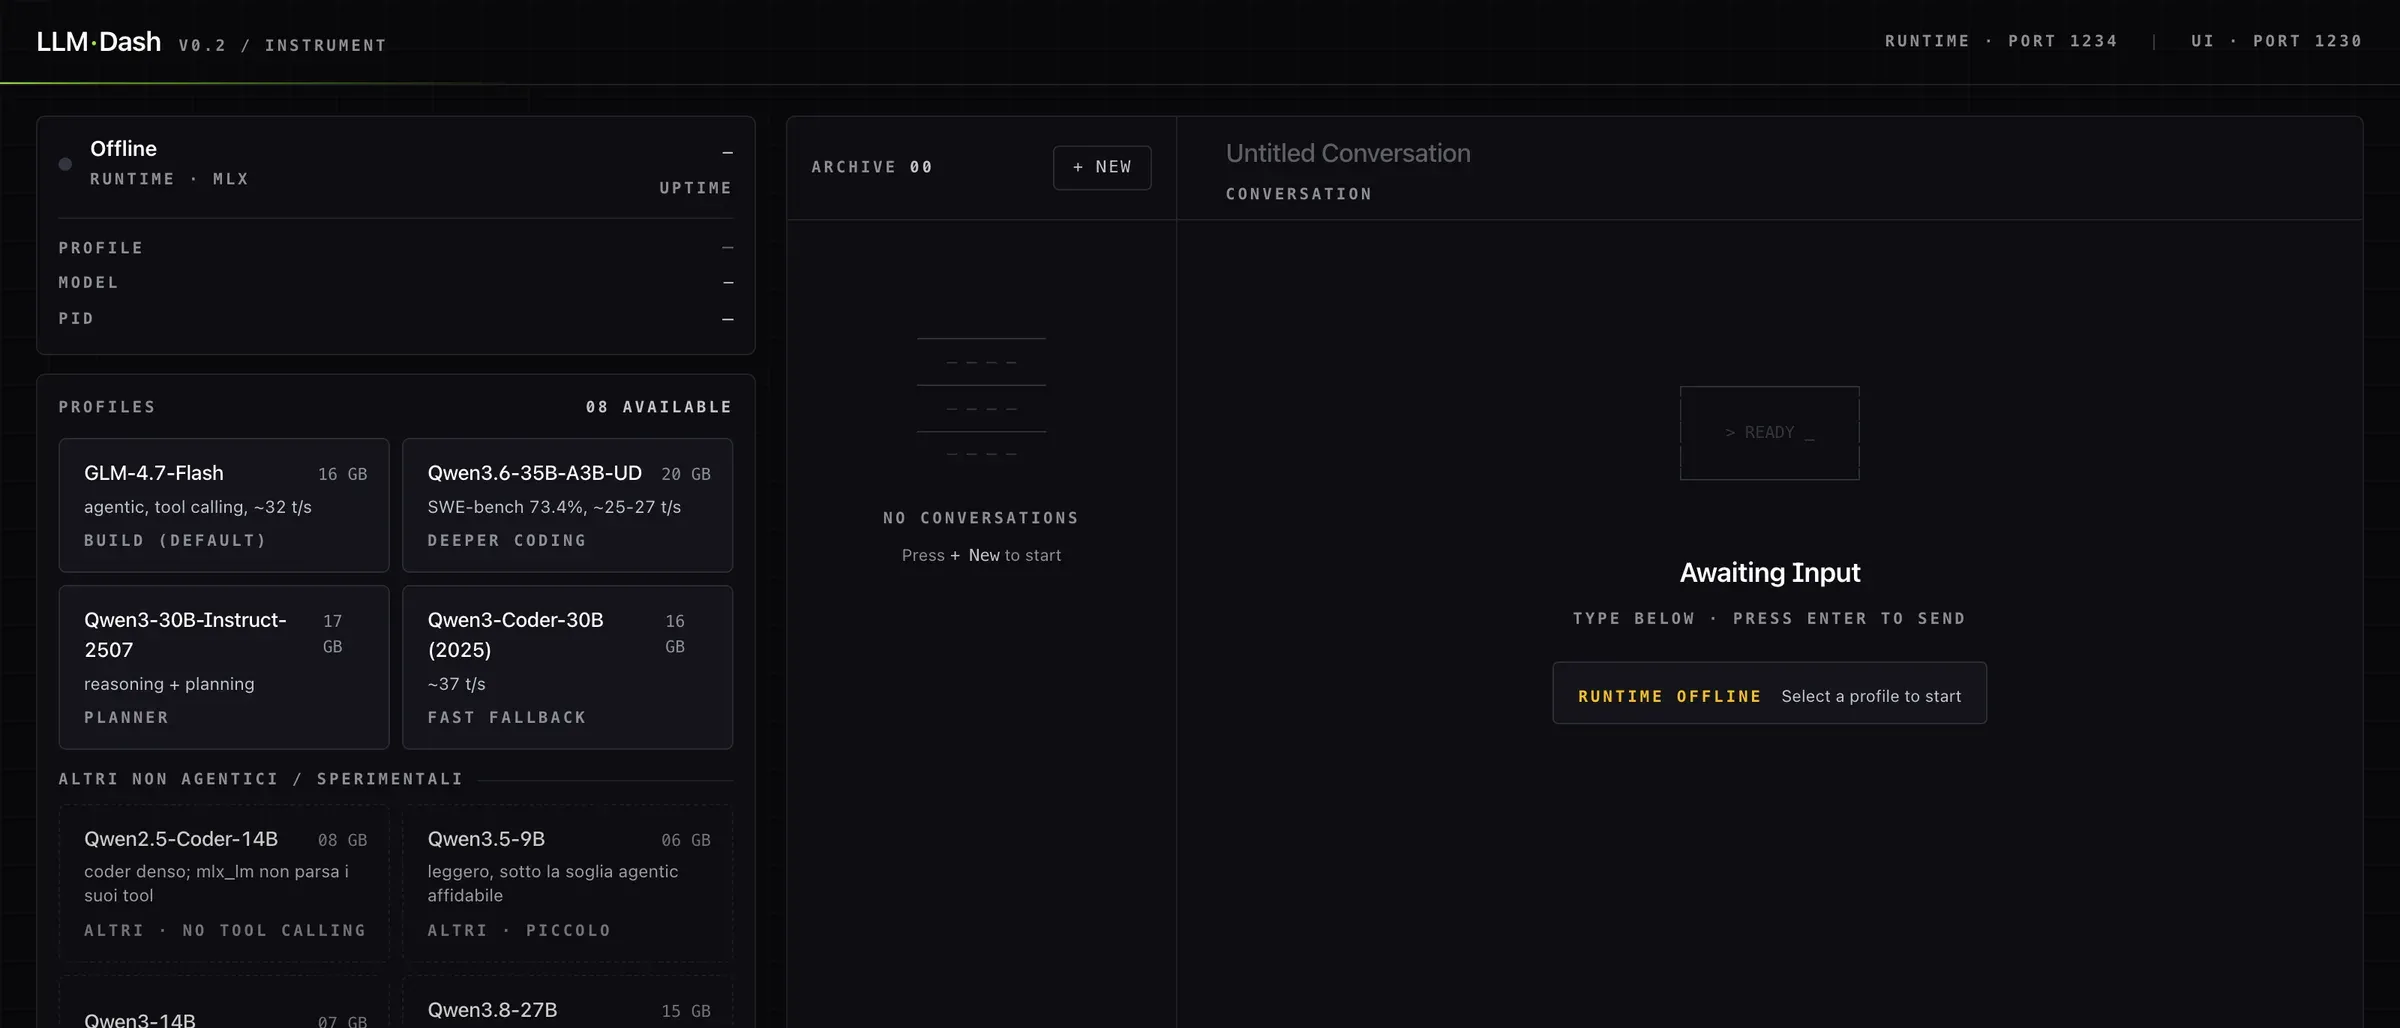
LLM Dash
Per usarli ogni giorno c’è LLM Dash, il pannello di controllo dei modelli locali sul mio Mac: quattro profili pronti (build, coder, plan e uno veloce per quando la memoria è stretta), avviati con mlx_lm.server, una dashboard per cambiare modello e tenere d’occhio memoria e velocità, e l’integrazione con opencode. Nei profili entrano solo modelli con il tool calling verificato davvero, con lo stesso harness degli esperimenti.